


第893回
インテル製GPU「Crescent Island」の正体、容量480GBメモリーでエージェント型AIとKVキャッシュ問題に挑む
2026年09月14日 12時00分更新
単体480GBメモリーで勝負するエージェント型AIとKVキャッシュの最適化
Crescent Islandのターゲットアプリケーションをまとめたのが下の画像だが、このSoftware Featuresの"KV cache efficiency"がすべてを物語っていると考えていい。
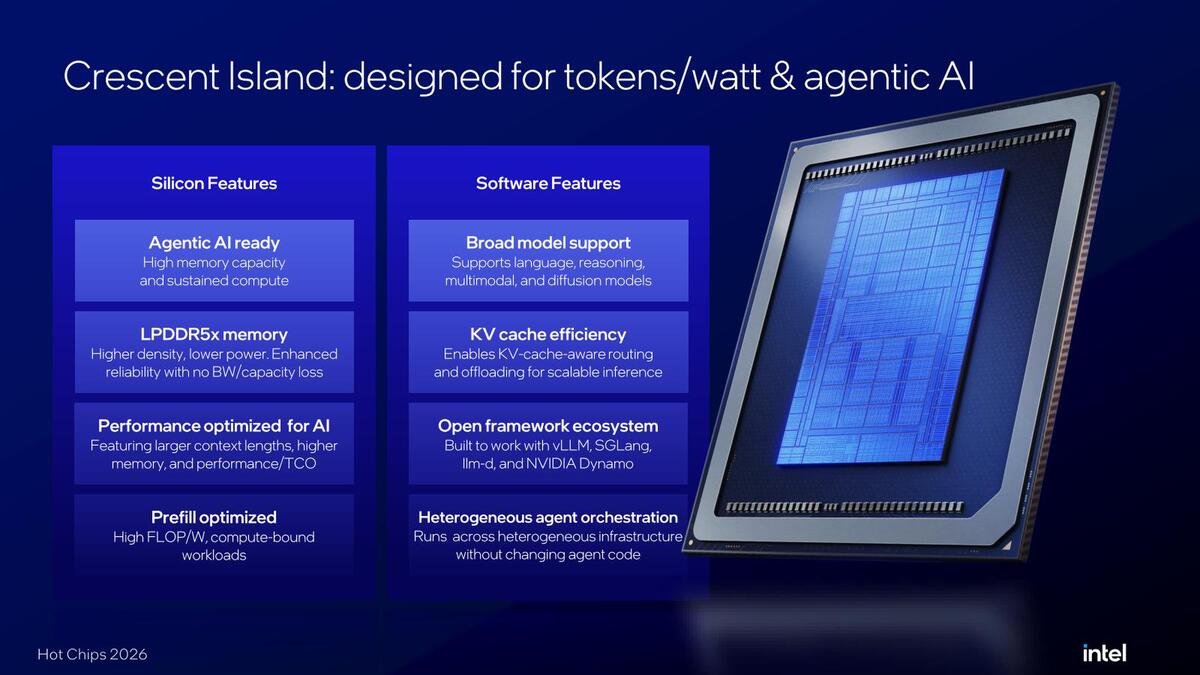
Silicon Featuresの最後には"Prefill optimized"とあり、実際にプリフィルでも活躍できるだろうが、本領はむしろデコードにありそうな気がする。もっとも、使い方はNVIDIAと異なるかもしれない
KVキャッシュの話は連載871回で一度説明しているが、エージェント型AIではプリフィルとデコードで処理を分ける。この際にデコード側では処理の効率化のためにKVキャッシュと呼ばれるものを構築するのが効果的なのだが、問題は昨今のLLMを使うとこのKVキャッシュが肥大化し、GPUのメモリーを食い尽くしてしまうことにある。
NVIDIAが突如としてGroq LPUを採用したのは、デコードの方はKVキャッシュのメモリーアクセスが性能に支配的であり、演算性能そのものは遊びまくっていて、NVIDIAのGPUでは効率が悪すぎたことに起因する。
逆にGroq LPUは演算性能こそ低いがメモリー帯域とメモリー搭載量がNVIDIAのGPUを凌駕しており、プリフィルをNVIDIAのGPU、デコードをGroq LPUと役割分担させることで、実効効率を最大化できるからである。
そしてCrescent Islandは(前ページ最初の画像にある脚注にも書いたが)このGroq LPUにあたる処理をターゲットにしているように見える。もっと正確に言えば、インテルはCrescent Islandでプリフィルとデコードの両方を分離せずに実行させるように見える。
理由は? というと、Crescent Islandには広帯域なスケールアップ・ネットワーク用のI/Fがない。PCIe Gen5 x16経由でKVキャッシュを他のカードと共有するのは帯域的に非現実的である。
そしてエージェント型AIではプリフィルこそ演算性能がモノを言うが、処理時間の大半を占めるデコードはメモリー帯域とメモリー容量がモノを言う。帯域だけならHBMの方が有利だが、ここであふれるとその先が遅くなる。
Crescent Islandは帯域はHBMにおよばないが、480GBの容量はKVキャッシュを丸ごと収めるのに十分であり、そして自分のローカルメモリーにKVキャッシュが全部収まってるなら他のノードにアクセスする必要もない。NVIDIAとはまた別の方法でエージェント型AIに最適化を図ったわけだ。
下の画像がメモリー容量に関する利点をまとめたものだ。同じモデルなら多くのセッションを処理できるし、同じモデルでより長いセッションを実施できる。
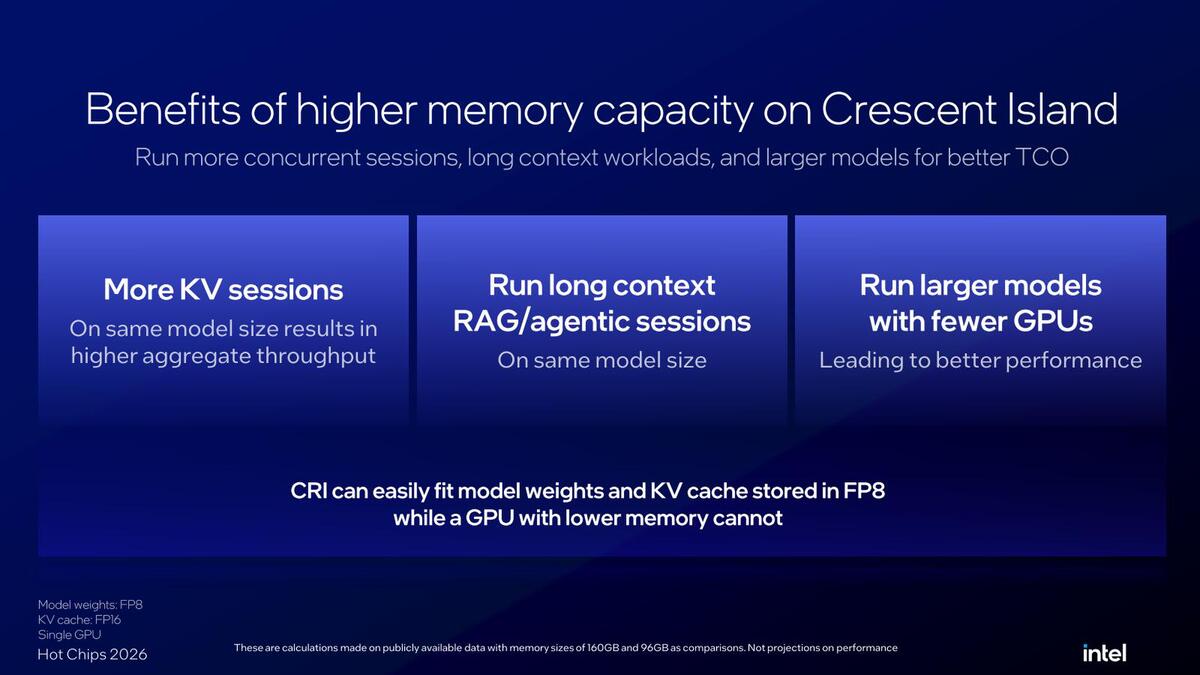
最近はKVキャッシュの圧縮などがいろいろ話題になっているが、これもちょっとしたことで精度が猛烈に落ちたりするので、なかなか難しい。FP8のままウエイトとKVキャッシュを収められるというのは確かに大きな売りである
NVIDIAではメモリーがあふれるので複数枚のGPUを連携させる必要があるところを、Crescent Islandでは1枚で実行できる。実行できるというよりも、1枚で実行する事にフォーカスした、というのが正確かもしれない。
今回は性能評価などは当然示されていないが、同じコストあるいは同じ消費電力枠で言えば、NVIDIAやAMDのソリューションよりも効率良くエージェント型AIを実行できる可能性は高い。問題は480GBが本当に将来のモデルでも十分か? というあたりであろう。
ただこうなると、ますますSambaNova SN50とどう棲み分けするのかが謎になってきたというべきか。発表の際にはこのあたりが明確になるとうれしい。
週刊アスキーの最新情報を購読しよう

本記事はアフィリエイトプログラムによる収益を得ている場合があります