


第897回
NVIDIA独自コア「Olympus」の真価 Vera CPUが見せたIPC全振りの重厚構造とメモリー帯域依存
2026年10月12日 12時00分更新
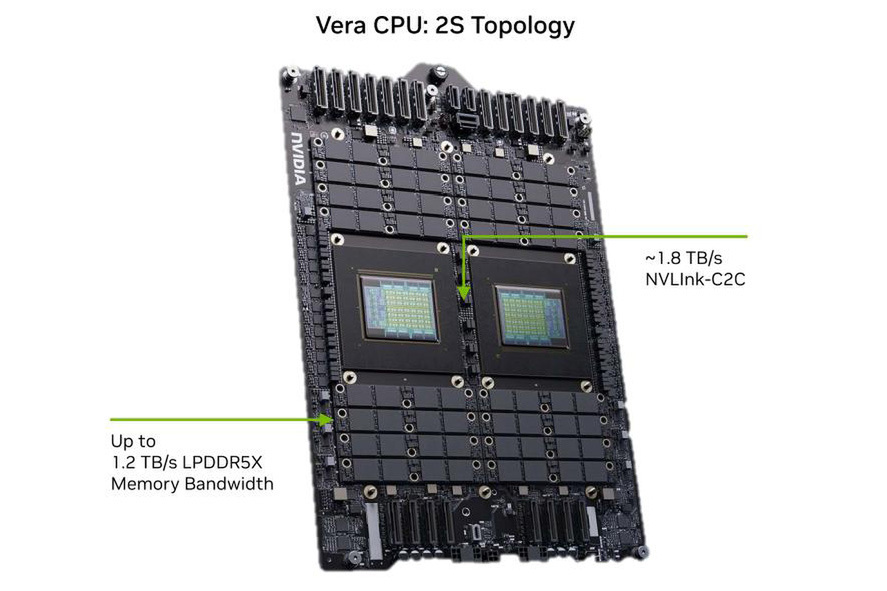
Hot Chips第6弾はNVIDIAのVeraである。前回のArm AGI CPUは、言ってみればArm v9.3-Aのお手本のような構成だったが、これをNVIDIAが実現するとどうなったか? というのが今回ご紹介するVera CPUとなる。
独自コア「Olympus」の全貌と
10-wideデコードを支える重厚なパイプライン
そもそもNVIDIAにとってCPUのインプリメントは最初ではない。まだNVIDIAがスマートフォン向けの市場に色気を出していた2011年、同社はProject DenverというCPUコアの開発プロジェクトを発表している。2012年頃の進捗は連載178回で触れた通り「なにもなし」。
そして2014年、このProject DenverにKeplerコアのGPUを組み合わせたTegra K1を発表するに至るが、結局NVIDIAはスマートフォン市場への参入を断念。最終的に2018年にリリースされたCarmelコアを搭載するTegra T194を最後に一旦独自CPUコアの開発は終了していた。もっとも水面下で言えばGPUに搭載する内部制御用のRISC-Vコアを開発していたりするから、CPUの開発そのものはずっと続けていたとは言える。
その後、データセンター向けにGrace CPUを開発するが、これはNVIDIAのNeoverse V2を利用したものであり、NVIDIAが設計したものではあるが、コアそのものを開発したわけではない。ところがVeraでは独自のOlympusコアを開発、これをインプリメントする形で構成された。
実はHot Chipsに先立ち、NVIDIA Technical BlogでVeraの詳細が公開されたのだが、Hot Chipsの内容はほぼこれをなぞったものとなった。とはいえ説明などが詳細に行なわれたし、質疑応答でわかったこともあるので、こちらを説明していきたい。
Veraに搭載される、NVIDIAが開発したコアはOlympusというコード名で呼ばれるコアである。Fetchは16命令/サイクル、Decode/Dispatchが10命令/サイクル、Issue Portが18というなかなか重厚なコアである。
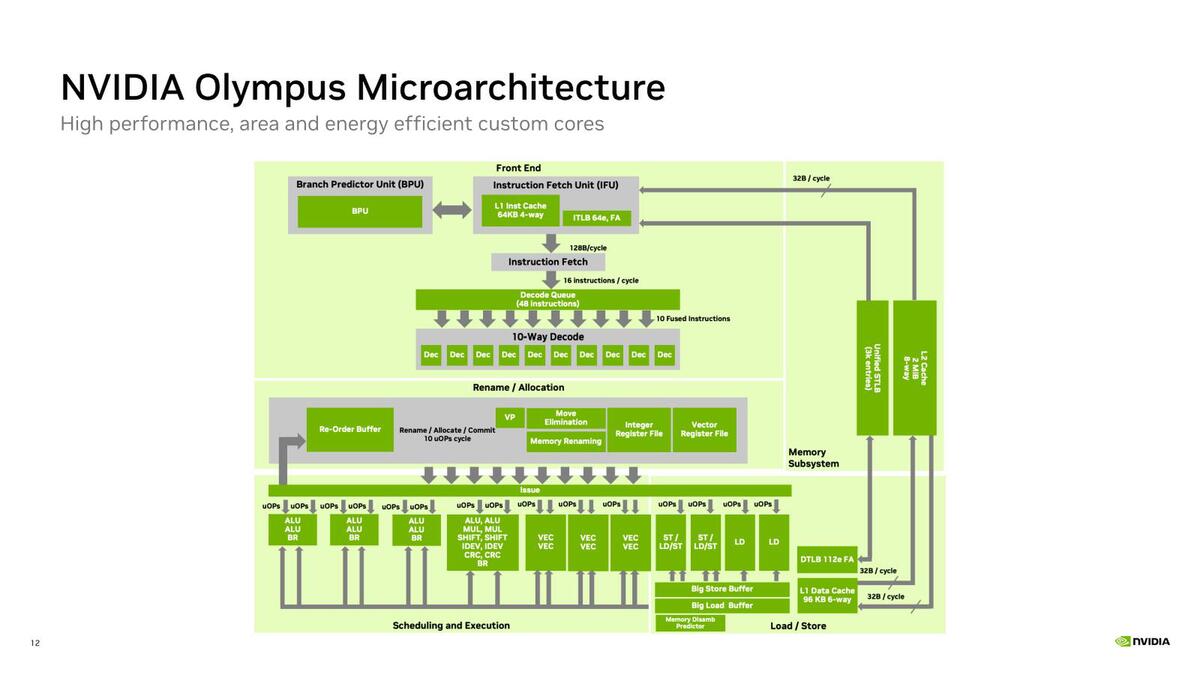
細かく言い始めるとキリがないが、"Big Load/Store Buffer"というのは、つまり他にもSmall/MediumのBufferがある意味なのか、それとも他の意味なのかいろいろと謎。あとRename/Allocation、つまりMid CoreにMove EliminationやMemory Renamingなど、あまり見かけない文言がある
この中でおもしろいと思う点はいくつかある。まずはDecode QueueとDecoderの間のやり取りが"10 Fused Instruction"となっていることだ。つまりDecode Queueの中でInstruction Fusionを行なっているという話だ。
これはAArch64ベースでの話であり、実質的に言えばDecode Queueでは実際にはAArch64を10命令/サイクル以上の速度で処理できていることになる。といっても無条件になんでもInstruction Fusionが可能とも思えない。
おそらく平均的な処理性能で言えば11~12命令/サイクル程度になるかと思われる。もっともそれをデコードでMicroOpに変換するわけだが、そのスループットは10命令/サイクルになっているわけで、この数字はArm AGI CPUと変わらないことになる。
ただ当然ながらMIcroOpそのものはOlympusとAGI CPUで異なっているから、単純に同じとも言いきれないというか、Olympusの方がIPCという観点ではやや上回っている気もする。
次に処理の話ではないのだが、一般にFetch~Rename/AllocationまではFront End、Issue以降をBack Endと称する。なぜならFront EndまではIn-Orderで動作し、Back EndはOut-of-Order動作になるからだ。
ところがNVIDIAのBlogではFetch~DecodeをFront End、Rename/AllocationをMid core、Execution意向をBack Endとして扱っている。この意図についてTech Blogでは以下のよう説明している。
「エージェント型ワークロードで、コードの解釈やオブジェクトの走査、実行時の状態管理やツールの出力の処理、グラフ状のデータ構造の探索など、相互に依存し合う一連の処理を長い連鎖として実行することがよく起こる。こうした処理経路について、パフォーマンスは命令フェッチだけでなく、先行する命令が分岐、メモリーアクセス待ち、または依存関係の解決のために待機している間に、コアが独立した処理を特定できる能力にも左右される」
「OlympusのMid Coreは、この隠れた並列性を引き出し、高速化するように設計されている。広範なRename、および割り当てエンジンがデコードされた命令を物理リソースにマッピングし、大容量のRe-Order Bufferと豊富な物理レジスター容量により、より多くの命令を処理パイプラインに保持し、より深いOut-of-Order実行を実現する」
「Memory Renameや値の予測、クリティカルパス加速などの依存関係解消機能により、ポインタを多用するコード、シリアル化されたメモリー操作、および長い依存関係チェーンによる実行Stallを低減するのに貢献する」
……のだが、いや普通にOut-of-Orderを実装する目的はまさにここに書かれている内容であって、程度の差はあってもこうしたことを目的としない実装はないように思われる。
わざわざMid coreとして分ける理由が今ひとつ不明である。余談だが、質疑応答で確認したところIn-Flight状態にできる命令数は返答がなかったが、ROB(Re-Order Buffer)のエントリー数は「1K以上」というすさまじい返事があった。
ということは少なく見積もってもIn-Flightできる命令は500を超えているように思える。ただそのためには、それに見合うRegister Fileを用意する必要があるわけで、搭載されているRegister Fileの量はAGI CPUなどと比べても間違いなく多いだろう。
それと実行ユニットの構成もおもしろい。ALUは2つを1組にしており、なのでALUユニットはトータルで4つ。それぞれにIssue Portが2つずつ割り当てられるが、ALUとBRが対になっており、BRは4つという猛烈に分岐処理能力の高い構成になっている。
ALU×4+ALU/BR×4にしなかったあたりになにかしらの意図を感じなくもない。またVector Unitだが、これは128bitのSVE2を3つ(実装的には64bit幅のVector Engine×6)という構成になっている。
なぜ256bitにしなかった、については「現在存在するソフトウェアエコシステムの大部分が(64bit幅の)NEONベースであるため、エコシステムを引き継ぐという多大な労力を要することになるからだ。その代わり、スカラー・ベクトル処理をより効率的に行なうことでパフォーマンスを向上させると同時に、マシンの総FLOPSを増加させるため、ベクターユニットの増設を選択した」という返答であった。
週刊アスキーの最新情報を購読しよう

本記事はアフィリエイトプログラムによる収益を得ている場合があります