


あずきバーだけじゃない 多角化経営を支えるIT部門の内製化への強い意思
データ連携を自分たちの手に取り戻した井村屋 CData Arcでシステムをつなぎ、AIにも挑戦
2026年11月12日 09時00分更新
「毎日がExcelを駆使した地獄」だった過酷な需給調整業務と、クラウド型需給計画システムの導入
きっかけは井村屋のビジネスの根幹を揺るがす壮大な改革とも言える2025年の「SCM(サプライチェーンマネジメント)標準化・需給計画システム導入プロジェクト」である。
これまで井村屋の需給管理は、山崎氏の言葉を借りれば「毎日がExcelを駆使した格闘の連続」であった。全国の営業から上がってくる販売予測、Oracleの物流システムが管理する出荷実績や外部倉庫の在庫、 kintoneの営業導入情報(定番特売)、 SCM部門の担当者が毎日ひたすら手作業で、巨大なExcelの見込み情報にコピペして集約し、需要と供給のバランスを調整していたという。
特に食品メーカーならではの『賞味期限』や『製造日』の制約が重くのしかかっていた。
「アイスクリームは賞味期限がありませんが、製造日ベースでの管理が必要です。一方で、チルド商品は極めて厳しい賞味期限があり、そこから、生産過程で組み立て配送を手配しなければなりません。この計算をExcelで属人的に処理していたため、大きなプレッシャーが担当者にかかっていました。在庫を多く持ちすぎれば、外部倉庫の保管料は膨大な金額になります。逆に在庫を恐れて欠品を出せば、お取引先やお客様に深刻なご迷惑をかけてしまいます」(山崎氏)
この「Excelとの格闘」を終わらせるべく、同社はクラウド型需給計画システム導入を決定した。このクラウド型需給計画システムはMicrosoft Azure上で動作し、データ連携は規定のCSVフォーマットに整形したデータを、指定のFTPサーバー経由で受け渡すという仕様であった。つまり、「kintoneの営業販売計画、社内のOracle(物流)とPostgreSQL(生産)から必要なデータを抽出し、自動でCSVに整形してFTPアップロードする仕組み」を構築する必要が出てきたのだ。
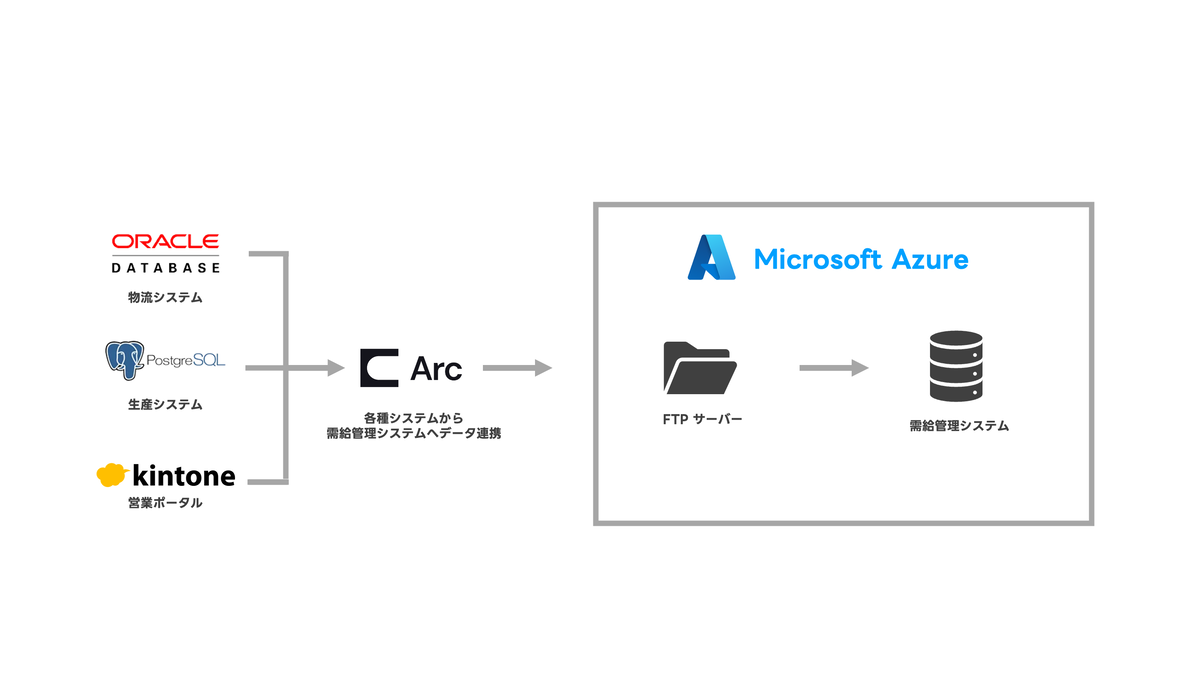
需給管理システムのシステム構成図
これを実現するため、データ連携ツールの選定が行なわれた。CData製品のみならず、他社の実績豊富な連携ツールが比較検討の対象に並んだ。しかし、他社連携ツールは基幹ベンダーから「構築費込み」のパッケージで提案された際、見積もられた開発コストはあまりにも高額だったという。
コストもさることながら、山崎氏らは「痛恨の過去」から、今回は絶対に自分たちの手でデータ連携を構築すると心に決めていたという。
「数年前、私たちは会計システムをクラウド化する際、基幹システムとの連携部分の開発を、すべてシステムベンダーにスクラッチ開発で依頼しました。ところが、要件定義の漏れや細かな仕様のすれ違いが多発し、結果的に『2回も最初から作り直す』という事態に陥ったのです。開発コストは当初よりも大幅に膨れ上がり、何より現場のメンバーが疲弊しきってしまったのです」
「その時、骨身に染みてわかりました。『ただ依頼する形ではノウハウが自分たちに残らず、スピードもコストも外部の状況に左右されてしまいます。ビジネスの状況に合わせて自分たちで即座にデータ仕様をコントロールできなければ、激変する市場にITが追いつけない』と。これが私たちの内製化への執念の原点です」(山崎氏)
「データ連携を自分たちの手に取り戻し、市場の変化に対応する内製化を実現する」という強い意志。そこで最終的に選定されたのがデータ連携ツール「CData Arc」であった。
SQL実務未経験の若手が背負った「巨大な役割」
2024年にデジタル戦略室に加わり、今回のCData Arcの実装を実質的に担当することになった赤塚昌平氏は、まさにその「内製化の覚悟」を現場で具現化した人物だ。
「前職は製造業のプログラマーだったのですが、実はデータベースのSQLに関しては資格試験でちょっと勉強した程度。実務でゴリゴリ書いた経験はほぼありませんでした。そんな私が、物流DB(Oracle)と生産DB(PostgreSQL)という異なるデータベースに同時接続し、それらをSQLで結合・抽出してクラウド型需給計画システム 向けの複雑なCSVを出力する処理を、担当することになりました。」(赤塚氏)
井村屋グループ デジタル戦略室 副主任 赤塚昌平氏
そんな赤塚氏は、データベースのテーブル構造を学び、SQLの文法に悩みながらも、CData Arcを使って構築したのは、高度なハイブリッドデータパイプラインだ。
具体的には異なるベンダーのデータベース(OracleとPostgreSQL)から、CData Arcの専用コネクターを使ってテーブルデータを直接取得。フローデザイナー上で視覚的に配置された「XML Map」コンポーネントの中で、異なる形式のデータを結合・マッピング。その上でクラウド型需給計画システムが求める正確なCSVフォーマットへ変換し、スケジュール起動(バッチ)によってAzure上のFTPサーバーと社内のBoxへ同時に転送するというものだ。
「エラーが発生するたびに、それが自分の書いたSQL文のミスなのか、データベース側の制約なのか、あるいはCData Arcの設定なのかが分からず、最初は本当に泥臭く試行錯誤しました。ChatGPT(GPT-4)にSQL文をレビューしてもらいながら開発を進めました」と赤塚氏は振り返る。
そんな赤塚氏の最大の支えとなったのはCDataのサポートだった。
「CDataのサポート窓口にエラーログを添付して質問すると、原則としてその日のうちに、驚くほど的確なアドバイスが返ってきます。時には、『エラーの原因はCData製品側ではなく、送信しようとしているSQL文のこの部分の結合条件の記述に誤りがある可能性があります。以下のように書き換えてみてください』と、自社製品のサポート領域を明らかに超えた、データベースクエリのデバッグまで一緒にやってくれました。この並走があったからこそ、SQL実務未経験の私でも、完璧な自動連携フローをカットオーバーさせることができたと確信しています」(赤塚氏)
1ヶ月の「紐付け地獄」を一瞬でワープさせた「AI自動マッピング」の衝撃
「実は、最近実装して一番鳥肌が立った機能があるんです」と、赤塚氏はCData Arcのフローデザイナーを指し示した。それは、基幹システムのレガシーデータを、現場の営業担当者や工場スタッフがiPadから手軽に参照できるようにするため、kintoneアプリへ商品マスタを同期する新しいフローを構築した時のことであった。
「基幹システムから抽出した商品マスタのテーブルデータは、とにかく項目数が多く、数十項目にも及ぶ複雑なデータ構造をしています。kintone側にも同じ数の項目を受け止めるアプリを作ったのですが、通常なら、この数十項目を1つずつマウスでドラッグ&ドロップして『この項目とこの項目を紐付ける』という地道なマッピング作業やそのテストを実施しなければなりません。そして、アジャイルに進めていたため、これらを何度もやり直しする必要があります。これを見た瞬間、『あ、これだけで数日は開発期間が潰れるな……』と覚悟しました」(赤塚氏)
そんな時、赤塚氏が目に留めたのがCData Arcのデータ連携マッピング(XML Map)コンポーネントに新しく搭載された「マッピングアシスト(AI自動マッピング)機能」だ。
「半分ダメ元で、画面上の『マッピングアシスト』ボタンをポチッと押してみたんです。そうしたら、くるくるマークが数秒回っただけで、一瞬にして数十項目がピシッ!ときれいに自動でつながったんです。目の前で起きたことが信じられなくて、『えっ、ワープした!?』と画面の前で、一人で大声を上げてしまいました(笑)。kintone側のデータ構造を読み取って、AIが自動で高精度に項目のマッピング関係を推測してつないでくれたんです。結局、数日かかるはずだった連携フロー開発が、実質わずか数時間で終わってしまいました。これには本当に感動しました」(赤塚氏)
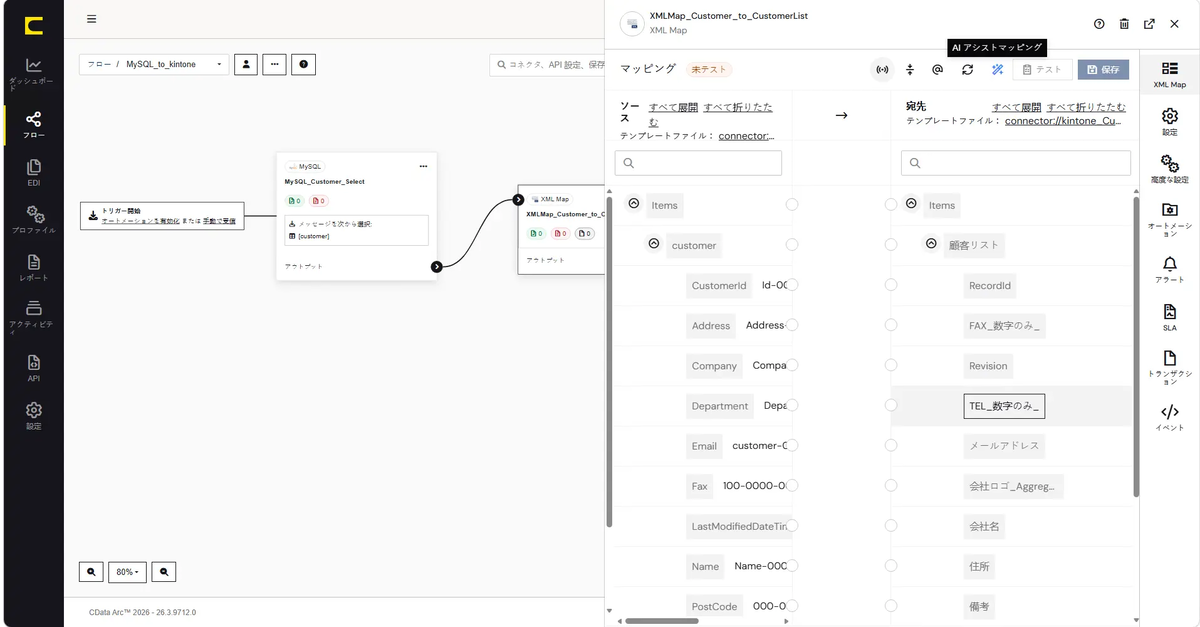
CData ArcのAPマッピングアシストの画面イメージ
CData Software Japan Customer Presales Managerの色川穂高氏は、「このAIマッピングアシストは、まさに開発現場での最大のボトルネックである『単純だけど膨大で神経を使う紐付け作業』からエンジニアを解放するために、私たちが技術的な粋を集めて実装した機能です。まさに赤塚さんのような現場のエンジニアにその価値を体感していただけて、最高の瞬間です」と笑顔で語る。
週刊アスキーの最新情報を購読しよう

本記事はアフィリエイトプログラムによる収益を得ている場合があります