


Meta、いきなりフロンティアAIモデル競争へ Opus 5.5やAstraを上回るベンチマークも
2026年10月13日 11時00分更新
AIモデルの競争で、OpenAIやAnthropicが目立つなか、Metaが一気に存在感を強めた。Metaは10月12日、AIエージェント向けのフロンティアモデル「Muse Wonder」と「Muse Wonder Full」を発表。ClaudeやGPTの上位モデルを超える公称ベンチマーク結果を披露した。
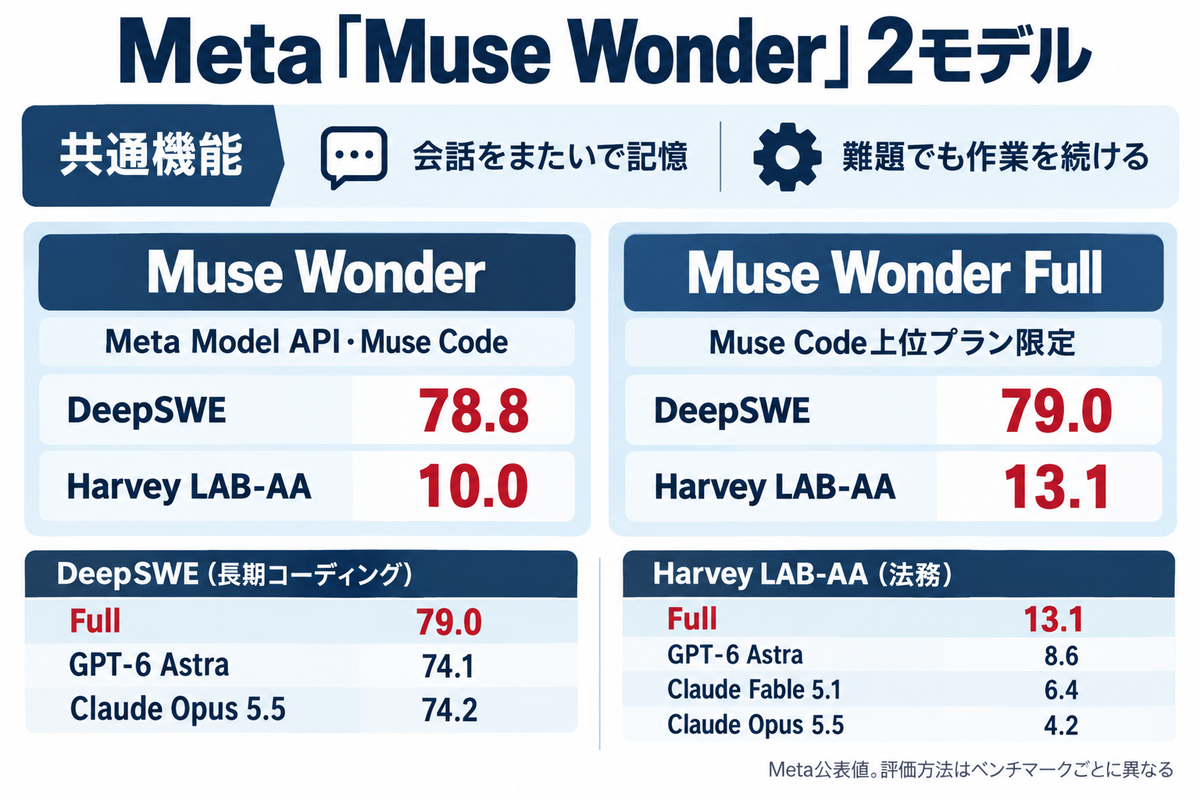
Metaの比較では、長期のソフトウェア開発力を測るDeepSWE 1.1で、Muse Wonder Fullが79.0、Muse Wonderが78.8を記録した。GPT-6 Astraは74.1、Claude Opus 5.5は74.2だ。法務文書を読み、実務成果物を作るHarvey LAB-AAでも、Fullは13.1で、GPT-6 Astraの8.6、Claude Fable 5.1の6.4、Claude Opus 5.5の4.2を上回った。
ただし、ヘルスケア分野のHealthBench ProではFullが62.3で、GPT-6 Astraの65.3やClaude Opus 5.5の65.6を下回るなど、分野によって得手不得手があらわれている。
2モデルは共通で、会話をまたいで重要な情報をおぼえる新機能「Active Memory」と、同じく難しい作業で別の手段を試しながら続ける「Active Focus」を搭載する。違いは主に性能と提供先だ。Muse WonderはMeta Model APIとMuse Codeで利用できる一方、より高性能なMuse Wonder FullはMuse Codeの上位プラン向けで、APIでは提供されていない。MetaはFullについて、より大きく強力な基盤モデルにより、学習時に想定していない課題にも能力が広がりやすいと説明している。
Metaは14ヵ月にわたってAI開発体制を刷新し、新モデルを同社のギガワット級データセンター「Prometheus」で訓練したとしている。これまでOpenAIとAnthropicが中心に見えたフロンティアモデル競争に、Metaがベンチマーク上で割って入った形だ。
週刊アスキーの最新情報を購読しよう

本記事はアフィリエイトプログラムによる収益を得ている場合があります